
製程不動,效能先漲:麒麟9050 Pro 的同節點迭代帳
極客灣實測麒麟9050 Pro:製程與架構不變下,CPU同頻功耗降逾三成、GPU峯值效能增39%、NPU算力提升150%,遊戲體驗追至驍龍8 Elite段位,本文拆解同節點迭代的效能來源與受惠承壓方。
9月13日,評測頻道極客灣(Geekerwan)發布華為新一代旗艦晶片麒麟9050 Pro的深度實測。整份報告最反常的地方不在分數,而在前提:架構與製程基本不變。在這個約束條件下,GPU的FP32吞吐量從1.4 TFLOPS拉到2.2 TFLOPS上下,NPU跑出67.7 TOPS的INT8實測算力、較前代增加150%,CPU在2.75GHz中頻點的同頻功耗減少逾三成。行動晶片的年度升級,向來把一半功勞記在電晶體密度推進的欄位裡,這一代麒麟把該欄位清空,全數改記在設計端。
效能從電路布局裡擠出來
極客灣把增益來源指向實體設計層的電路布局優化。同一節點上重新規劃供電網路與繞線,最直接的兌現是同頻功耗:2.75GHz中頻點較前代省電超過30%,3.1GHz峯值頻點在功耗沒有顯著增加的情況下,效能明顯提升。極客灣為了跨平臺可比性,移植了原生SPEC CPU 2027,同系列的Geekbench 7則跑出單核峯值1813分、多核峯值8159分。
頻率取捨是第二個槓桿。3.1GHz的峯值時脈放在當代旗艦裡並不激進,競品超大核早已跨過4GHz門檻;極客灣的判讀是,該頻點仍處於能效斜率的合理區間,屬於克制而非冒進的方案。絕對效能的天花板由此標定,但中低頻段的每瓦輸出才是日常使用真正的結算欄位。
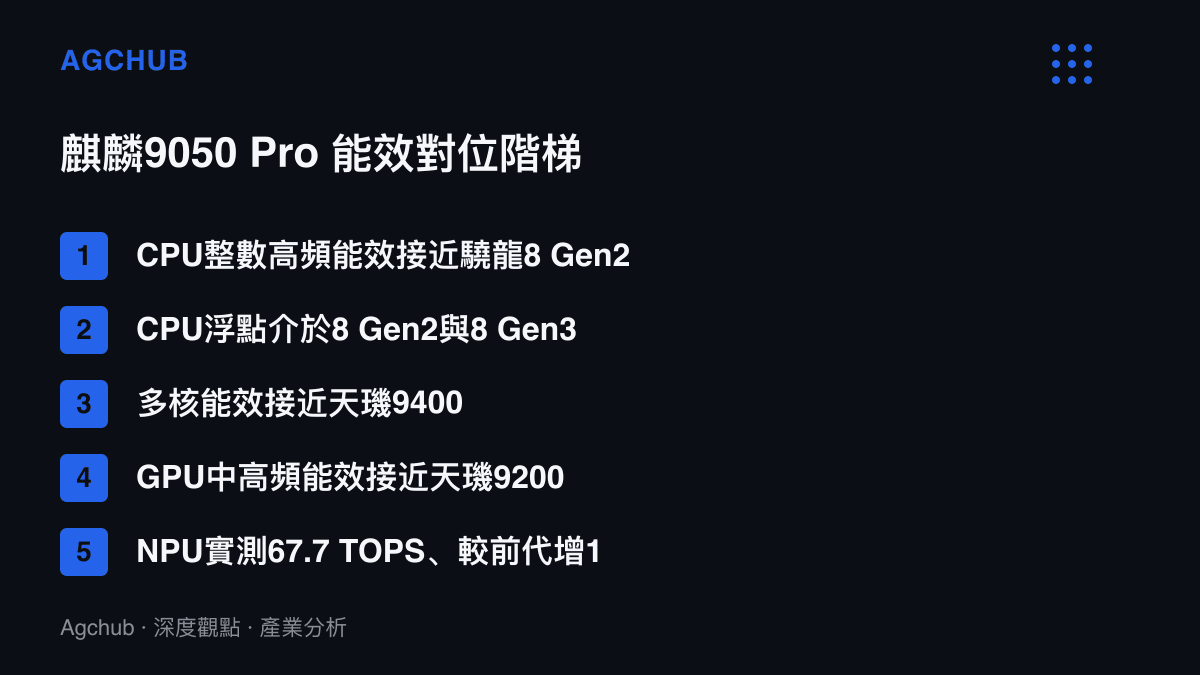
第三個槓桿在核心分工。能效大核側重低頻點表現,性能大核在低頻能效追平驍龍8 Gen3、高頻性能接近但功耗略高,多核能效整體接近聯發科天璣9400。面積預算被優先配置給續航敏感的頻段,峯值跑分退居次要。
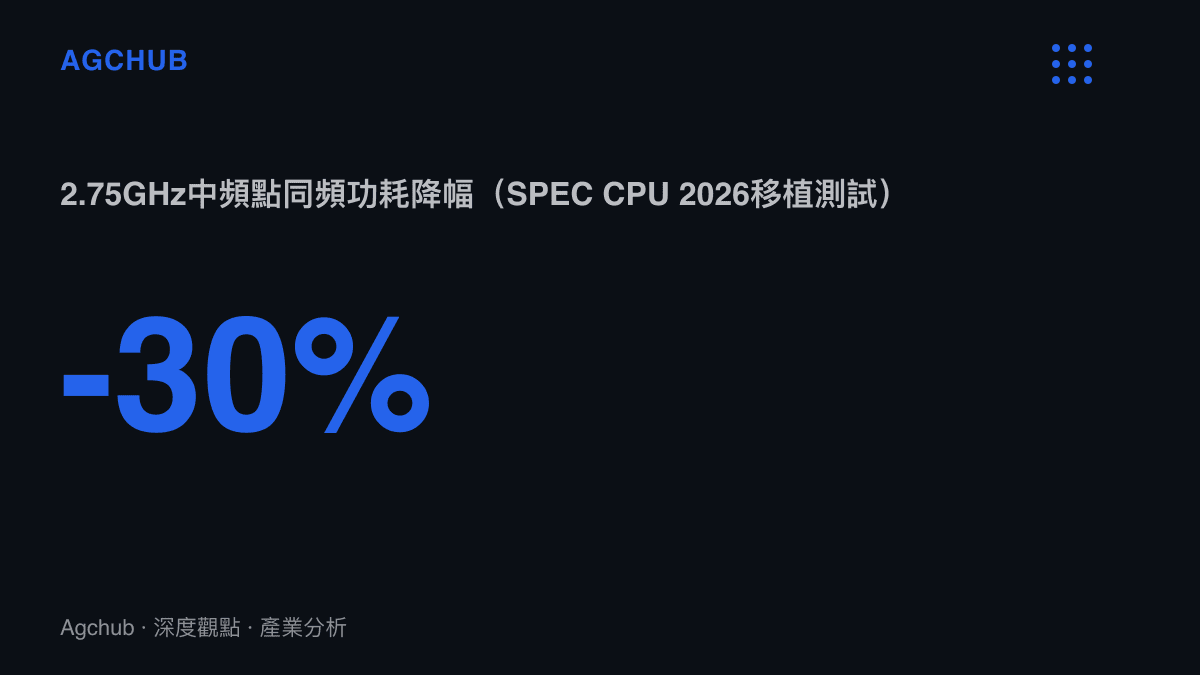
把時間軸拉長,這組數字的分量更清楚。麒麟9000是2020年臺積電5nm的絕版批次,2023年Mate 60系列的麒麟9000s以國產節點重啟產線,其後每一代的能效增量,都產生於沒有製程紅利可用的條件下。本次3DMark Steel Nomad Light的1378分,峯值效能較前代提升39%,約為麒麟9020的三倍。同節點條件下三年累積的幅度,已經接近一次節點遷移的量級。
能效階梯的真實座標
段位追平是體感結論,絕對能效仍要分項對表。CPU整數高頻能效接近驍龍8 Gen2,浮點落在8 Gen2與8 Gen3之間;GPU中高頻能效接近天璣9200,中低頻介於驍龍8 Gen2與8 Gen3之間。以高通自家旗艦的代際時序衡量,通用運算單元的能效大約落後兩個世代。
唯一反向超車的欄位是NPU。INT8卷積神經網路測試集實測67.7 TOPS,貼近70 TOPS的理論值,極客灣稱其達到業界領先水準。資源傾斜方向與鴻蒙7的端側AI路線一致:當算力競賽的主戰場從通用運算移往推論,華為把最強的單元放在最可能兌現差異化的位置。
遊戲兌現率:缺口由誰補上
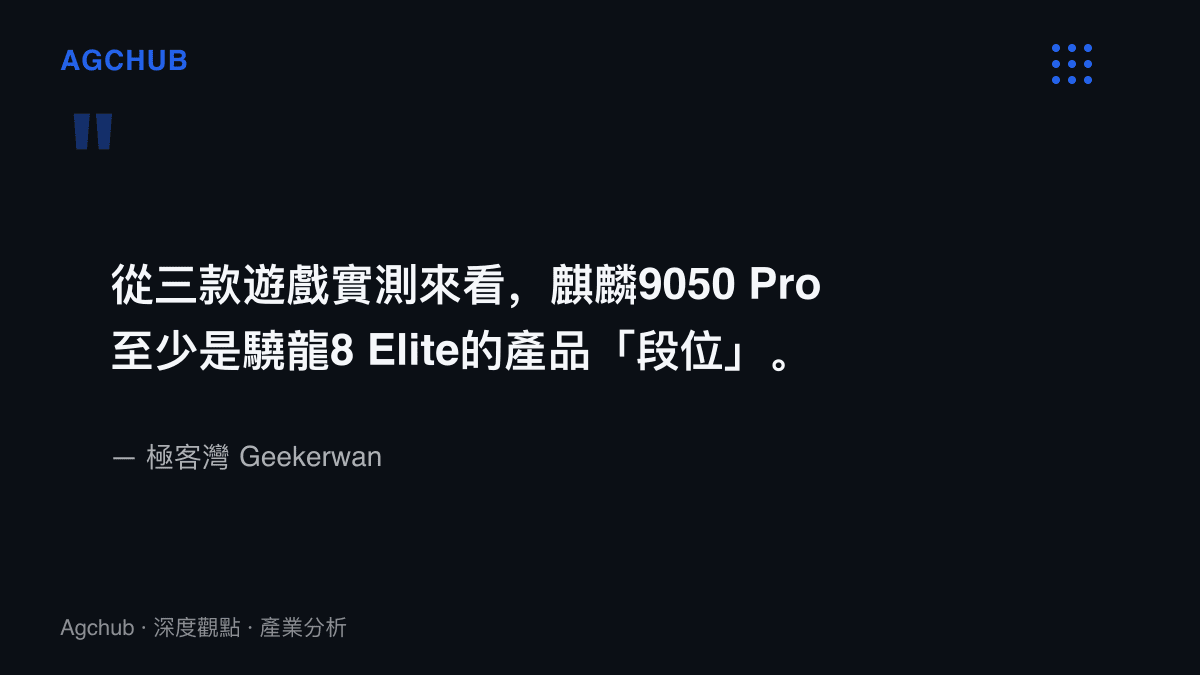
分數落後兩個世代、遊戲體驗卻站上同段位,中間的缺口由兩端填補。一端是軟硬整合。極客灣在結論中明言,華為完成自研晶片與軟體生態的深度整合後,能夠提供與當代旗艦同級、甚至更流暢的體驗。排程、渲染管線與溫控策略在系統層針對自家晶片定製,規格表上的吞吐量差距,被兌現率差距部分抵銷。這與先前鉸鏈規格趨同、系統圖層仍分界的摺疊機復刻實驗指向同一結構:硬體差距縮小之後,分水嶺移往軟體權限與整合深度。
另一端是載體。測試機為Mate XT2三摺疊,對照組是搭載驍龍8 Elite的三星Galaxy Z TriFold。三摺機的機身體積意味著更大的散熱質量與供電餘裕,峯值效能的可維持時間隨之拉長。三款遊戲的方向一致:《原神》在解析度明顯高於三星的前提下全程滿幀,1% low幀反而超越對手;《異環》解析度相近,平均幀率持平甚至小幅領先,較華為前代三摺接近翻倍;《鳴潮》以較低解析度換取更高的平均幀率。
影響推演
受惠方清單不長,份額集中。華為的超高端產品線排在第一順位:體驗短板補齊後,三摺疊的價格帶已站上傳統旗艦兩倍以上的位置,對照蘋果首款摺疊機逾兩千美元進場的價格階梯,品類內的性能對位不再構成折價理由,硬體毛利與生態黏著度同步受惠。鴻蒙裝置基數是第二順位,晶片體驗與系統版本綁定愈深,換機的跨生態成本愈高。
承壓方有兩處。高通在中國超高端市場的晶片獨佔敘事被削弱:當對位測試中,搭載驍龍8 Elite的三星機種未能在幀率或解析度上取得優勢,旗艦晶片的溢價需要新的支撐點。三星的摺疊旗艦則在自家最強的供應位置上,被對手以更高解析度滿幀對照,差異化的壓力轉向螢幕與機構以外的欄位。天璣9400與9200在報告中被反覆用作能效錨點,聯發科高端定位的參照系也隨之被重新校準。
成本面沒有免費的午餐。同節點擠能效依賴更多工程工時與驗證輪次,每一輪布局調整都對應新的光罩與投片開支,且這些前置投入由自家機型全數吸收,沒有外部客戶分攤。垂直整合的代價結構由此可見:多付的設計成本,換回排程主導權與差異化的全額回報。
同節點紅利的剩餘期限
實體設計的增益存在遞減律。第一輪布局優化擠出三成功耗、近四成峯值,屬於容易採收的部分,下一輪的邊際收益只會收窄。若製程持續凍結,能效階梯要維持目前的相對位置,端側AI與軟體棧必須承接更多工作負載的移轉,NPU那150%的增幅正是這條路徑的預付款。反之,任何一級國產製程的推進,都會讓「段位相同、效率仍有差」的現狀快速翻面。這份實測證明的是一條替代路徑的存在,以及它的計價方式;路還能走多遠,取決於下一張製程門票的發行時間。