
沒有賽道的物理世界紀錄:熱搜背後的計分板與成本帳
一條擠進微博熱搜的 AI 物理紀錄,本文從測試集取代秒錶的計量結構、基準壽命從約九年縮到約兩年的速度曲線,到訓練與推理兩端的成本歸屬,拆解這類紀錄的生產線與兩側的受惠承壓方。
田徑的世界紀錄以百分之一秒計,舉重以公斤計,跳遠以公分計。擠進微博熱搜第二十位的這條「Claude 刷新物理學世界紀錄」,計量單位是另一種東西:測試集上的分數。場地換成試卷,秒錶換成逐題比對。
翻查詞條內容,看不到賽道長度,也找不到計分口徑與測試集名稱。這個空缺本身就是資訊:AI 產業的世界紀錄已經量產到不需要附規格書,傳播端照單全收。競技敘事的外殼,裝的是模型能力的行銷。
這條生產線有明確起點。2025 年 11 月,Google DeepMind 發表論文,Gemini 2.5 Deep Think 在該年國際物理奧林匹亞(IPhO)的官方試卷上跨過金牌門檻,論文標題直接寫著「邁向 AI 金牌選手」。熱搜上的 Claude,是把這條曲線再往上推一格的最新章節。要估這一格值多少錢、會砸到誰,得先拆開計分板本身。
從賽道到試卷:計分板的三層結構
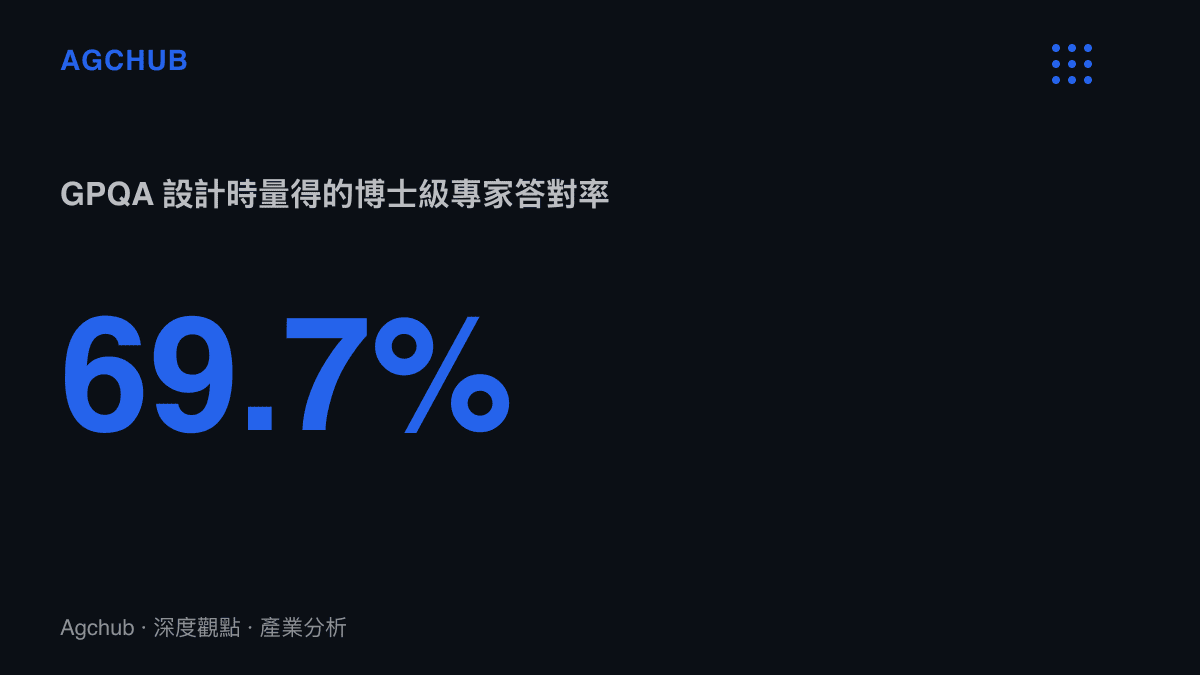
評測 AI 物理能力的板子有三層,硬度遞增。第一層是選擇題型的研究生級測驗,代表是 GPQA:由博士級出題者撰寫、跨領域專家驗證,2023 年發布時量得的領域專家答對率約 69.7%,設計意圖就是讓搜尋引擎幫不上忙。第二層是競賽試卷,IPhO 理論 30 分加實驗 20 分、滿分 50 分,須要多步推導與跨章節搬移,金獎名額約佔參賽者百分之八。第三層是以小時計的多步研究任務,題目沒有標準答案,計分單位是完成度。
三層板子上的人類參照點,在兩年內被逐一改寫。GPQA 發布當年,GPT-4 的答對率不到四成,明顯低於設計者量得的專家線;到 2025 年,前沿模型在 GPQA Diamond 子集普遍站上 85% 上下,最高逼近 88%,把 69.7% 的專家基準拋在後面。競賽卷的進度慢一拍,DeepMind 的論文裡,模型在理論題的表現先於實驗題,實驗部分依賴把儀器操作文字化後再作答。這個順序決定了替代曲線的形狀:紙上推導先被喫下,動手與量測留在後面。
紀錄的保鮮期,從九年縮到兩年
計分板愈多,單條紀錄的壽命愈短。Epoch AI 在 2024 年的盤點顯示,2015 至 2019 年間設計的基準,從發布到被前沿模型做到九成正確率,平均要花約 9 年;2020 年以後設計的基準,平均約 2 年就飽和。照這個速度,任何「刷新世界紀錄」的行銷窗口,比一支手機旗艦的產品週期還短。
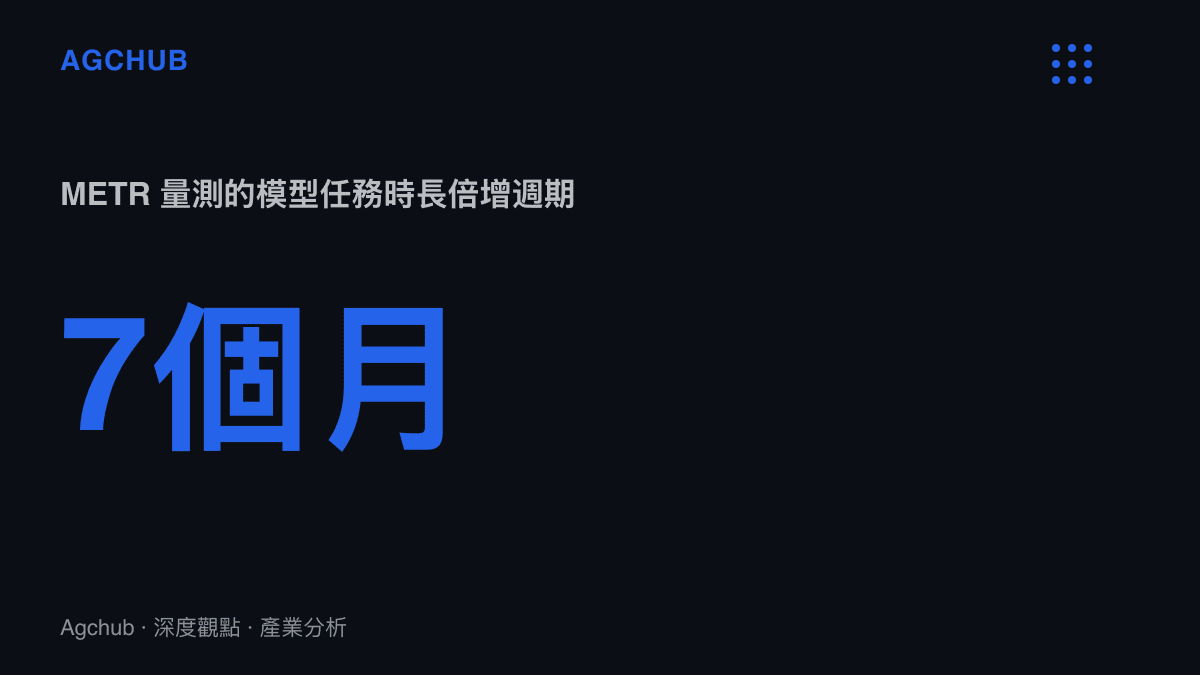
任務長度端的量測更陡。METR 在 2025 年 3 月的報告中迴歸 2019 至 2025 年的前沿模型,得到一條規律:模型以五成成功率可完成的任務時長,每 7 個月翻一倍,從 GPT-2 時代的數秒,推進到 2025 年前沿模型的一小時上下。物理競賽題落在分鐘到小時級的區間,正好騎在這條倍增曲線上,紀錄被刷新是常態,守住才是新聞。
保鮮期縮短,直接改變紀錄的經濟屬性。它離可累積的資產愈來愈遠,離一次性素材愈來愈近:一條紀錄的價值集中在發布後的頭幾週,之後折舊到零。發行方抓緊窗口投放,採購方則被迫在更短的週期裡重估手上的工具鏈。
刷新紀錄的兩本帳:訓練端與推理端
紀錄的生產成本記在訓練端。史丹佛《AI Index 2025》估算,GPT-4 的訓練算力成本約 7,800 萬美元,Google 的 Gemini Ultra 約 1.91 億美元,新一代前沿模型已往 10 億美元量級走。這些支出支持的目標清單裡,榜單成績與長任務能力併列,物理試卷上的分數屬於副產品,卻是少數能讓一般使用者一眼看懂的副產品。
訓練支出往上墊,資本支出同步膨脹。微軟、Alphabet、Meta、Amazon 四家 2023 年合計資本支出約 1,400 多億美元,2025 年依財報與指引合計已超過 3,000 億美元,兩年翻倍有餘。榜單上的每一次刷新,都為這筆支出的下一輪續行添一條理由,形成支出、紀錄、採購、再支出的循環。
推理端則是另一種帳。2025 年 11 月發表的 Claude Opus 4.5,牌價為輸入每百萬 tokens 5 美元、輸出 25 美元。以一份 IPhO 理論卷三大題、含多輪自我修正合計 20 萬 tokens 輸出推估,推理成本約 5 美元,加計輸入與重試,落在個位數美元。對照人類端:一名 IPhO 金牌選手的養成,是數年的專項訓練與層層淘汰的選拔體系。同一單位「金牌級解題能力」的取得成本,正從數年人力滑向一次 API 呼叫,結構上與電影感取得成本的價格塌陷同構:專業產出的單價被壓進訂閱費的邊際裡。
傳導鏈上的受惠方與承壓方
受惠端第一位是算力與雲端。物理榜單是最容易跨語言傳播的能力證明,中文熱搜的出現代表採購敘事已完成本地化,企業資訊部門的預算審查桌上,又多一頁可引用的成績單。第二位是科學計算工具鏈:文獻資料庫與模擬軟體接入模型介面後,榜單每上一格,介面的溢價空間跟著放大。
承壓端集中在知識的封裝層。競賽補教與解題付費內容的定價基礎,是金牌級講解的稀缺性;當模型以個位數美元的成本輸出同級推導,稀缺性移向出題與判題兩端,中間的講解環節被壓薄。這條路圍棋教學市場已經走過一次,柯潔以一支入門影片重排圍棋教學貨架時,被擠壓的是課時經濟裡的中介層;物理教學這回進場的對手,邊際成本趨近於零。
慢變數在實驗端。濕實驗室與儀器操作構成的門檻,短期內無法被文字化試題取代,DeepMind 的論文也把實驗部分列為相對弱項。人類端的價值往動手與驗證遷移,純推導環節的議價力先行承壓,同樣的順序正在化學與生物的評測上重演。
飽和之後:計分板的下兩站
照約兩年的基準壽命推算,競賽級物理試題在 2027 年前後進入飽和區,計分板將往兩個方向遷移。其一往長任務走:多日期研究專案與論文重現,METR 的量尺已鋪到小時級,下一格是天級。其二往封閉題庫走:IPhO 決賽題每年考後才公開、單次使用,這種一次性試卷反而成為稀有資源,採購方開始付費取得未外洩題目做現場評測,評測本身長出一門生意。
熱搜會退,計分板會換。值得留在帳本上的只有兩行:一單位金牌級解題能力的價格,正從數年養成成本滑向個位數美元的推理費用;而每一條新世界紀錄出現時,先核對它的計量單位與出題來源,再判斷該由誰付帳。