
15%、9%、3%:頂尖模型分差一年縮掉八成,剩下的差距移往牌價
以彭博行業研究十月初的報告為座標,本文拆解中美頂尖模型LiveBench分差一年內由15%收斂至3%的路徑,檢視榜單前十五名僅三席中國模型的縱深落差、國產硬體優化推動的推理成本下探,以及分數趨同後競爭軸轉向API牌價與資本支出回收期的傳導方向。
15%、9%、3%。按時間排列,三個數字分別對應2026年初、5月與9月底,中美頂尖AI模型在基準測試上的平均分差。10月5日,彭博行業研究高級分析師羅伯特・利亞(Robert Lea)在報告中確認,這項差距已降至歷史最低水準,美國 AI 公司相對中國同業的性能領先,正被逐季改寫。
這次讀數的觸發點,是 DeepSeek 9月發布的 V4.1 Flash。該版本在 LiveBench 全球排名登上第六,成為這家公司自2025年憑推理模型 R1 取得突破以來,排名最高的中國模型。利亞對後續的判斷寫得直接:性能持續提升,意味著中國競爭者將進一步擴大市佔。
一年縮掉八成的分差,縮在哪裡
把分差換成相對幅度更直觀:15%到3%,一年內差距壓縮八成。這條收斂曲線並不平滑。美國實驗室每隔數月互超一輪,OpenAI、Anthropic 與 Google 的座次輪替本身就會讓分差震盪,利亞也在報告裡提醒,這類排名會不斷變動。趨勢線上真正值得記錄的是間隔:每一輪美方前沿發布拉開的差距,都比上一輪更窄,被追平所需的時間也更短。
歷史座標可以拉回2025年1月。R1 上架當週,輝達單日市值一度蒸發約5,900億美元,演算法效率對算力堆疊的替代效果,第一次被大規模寫進股價。二十個月後的 V4.1 Flash,命名本身已說明路線:Flash 版本走效率與成本取向,延續 R1 以來用單位推理成本換性能的打法。這家公司的滲透也早已溢出工程圈,其擬人形象之爭一度擴散到同人創作圈,DeepSeek 同人市場的標準之爭最終以一方全面下架作品收場。
頭部收斂,縱深未動:榜單的兩層結構
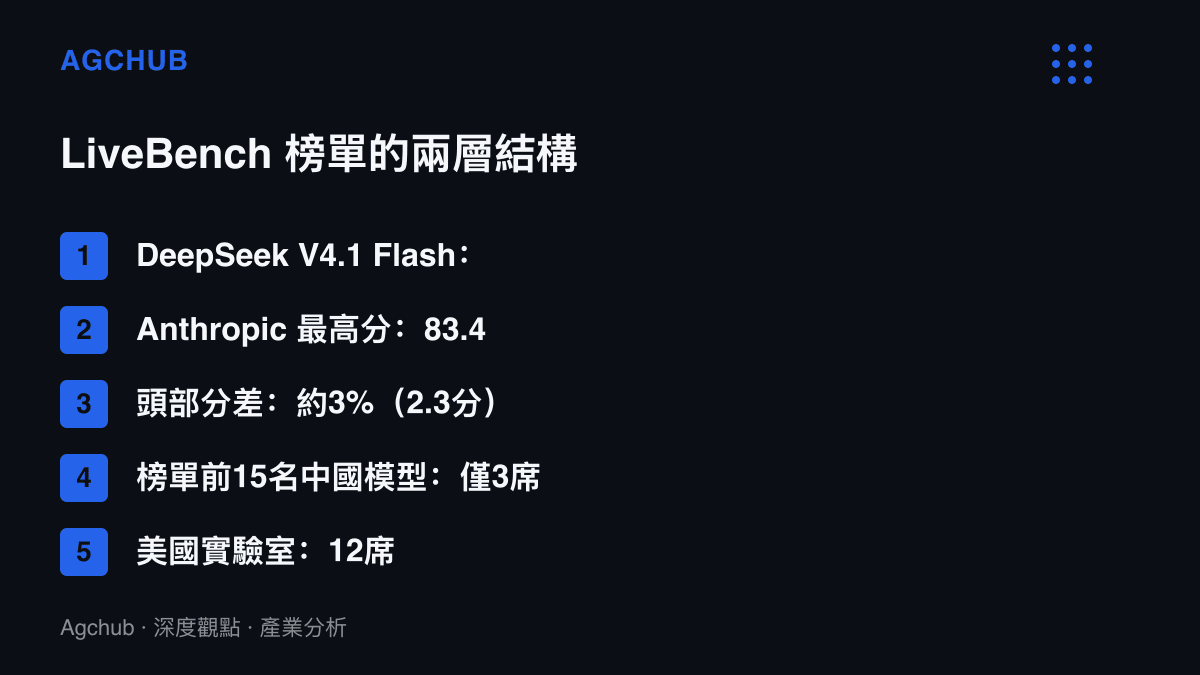
LiveBench 的計分方式,是讓模型回答問題、謎題與任務並逐題評分,性質接近智力測驗。DeepSeek 最近一次得分81.1,低於 Anthropic 的最高分83.4,相差2.3分,換算約3%。利亞據此認定,DeepSeek 的表現已可與 Anthropic、OpenAI 的領先系統匹敵。
榜單往下看,結構沒有跟著頭部收斂。前十五名裡,中國模型只佔三席,其餘十二席仍由美國實驗室包辦,厚度是4比1。對企業採購而言,這個落差有實際意義:冠軍模型的分數趨同之後,決定遷移成本的是可用型號數量、版本迭代速度與生態配套,而這三項目前仍偏向美方陣營。
出口管制反轉出來的成本曲線
彭博在報告中把中國模型的進步歸因於兩件事:AI 專業能力的持續深化,以及研究人員針對國產硬體優化模型的能力。第二件事值得展開。出口管制的設計初衷是卡住先進算力供給,實際效果是把工程資源推向另一條路徑:軟硬體協同優化。DeepSeek 先前開源面向華為昇騰算力平臺的基礎設施組件,且與輝達平臺逐一對應,等於把遷移成本分攤給開源社羣共同負擔。
利亞的措辭更進一步:這些進展讓人質疑美國在 AI 領域的科技主導地位能否長期維持,也讓出口管制的有效性再度被打上問號。從成本結構看,這條路徑的產出有兩層。模型分數追上前沿是表層讀數,單位推理成本的持續下探才是深層變數,後者構成價格競爭的彈藥庫。
分數趨同之後,競爭軸移向牌價
利亞在報告裡留了但書:無論模型在排行榜上的排名如何,變現都可能很困難。這句話對兩側同時成立。頭部分差縮到3%之後,分數本身失去鑑別力,採購決策自然轉向價格、延遲、生態與合規條件。牌價的歷史曲線已經給出方向,本站先前整理過 前沿模型 API 輸入牌價兩年下降約三百倍 的紀錄,基準領先的儲存期限逐輪縮短,領先與被追平之間的窗口越來越窄。
DeepSeek 的定價紀錄強化了這條傳導鏈。R1 上架時的輸入牌價為每百萬代幣0.55美元,OpenAI o1 同期是15美元,價差二十七倍。性能差距縮到3%的現在,這種量級的價差直接改寫採購算術:對成本敏感的企業用戶來說,3%的分差撐不起數倍溢價,第二供應來源的談判價值反而上升。
誰受惠、誰承壓
受惠端可以按序排開。中國實驗室拿到市佔擴張的入場券,利亞的報告直接點名這個方向;華為昇騰生態承接需求,模型層的優化每深化一步,遷移到國產算力的摩擦就少一分;成本敏感的企業用戶拿到議價籌碼,同級能力出現第二供應來源後,合約談判的參照系整組重寫。
承壓端集中在美國陣營。實驗室的 API 溢價最先被壓縮,83.4對81.1的差距撐不起價格上的數倍落差。往上遊傳導,超大規模資料中心的資本支出敘事建立在能力領先換取定價權的假設上,領先縮至3%,每代幣營收的下滑會直接反映在回收期試算。榜單本身的行銷價值也在折舊:頭部分數彼此貼近之後,LiveBench 名次對採購決策的解釋力下降,這對習慣以基準成績做傳播的兩側都是減項。
三種情境與下一次讀數
情境一,分差穩定在5%以內:採購標準從分數移向價格與生態,市佔轉移加速,API 牌價下行成為常態。情境二,美國下一代前沿模型重新拉開差距:過去兩年這種擺盪反覆出現,差別在於每一輪的高點與低點同步上移,中方模型的分數地板沒有被推回原點。情境三,變現約束同時綁住兩側:榜單名次換不來現金流,最後比的是成本結構的續航力。
三個情境的交集指向同一組檢驗點:美國下一輪前沿發布之後的分差讀數,以及兩側 API 牌價的相對變化。3%是單一時點的快照;連續可追蹤的紀錄,向來記在牌價與資本支出回收期上。