
10 個記憶檔對 413 個:Claude 的做夢研究,把 AI 運算拆成醒與睡兩本帳
以 Anthropic 拆解 Claude 代理記憶的四層結構與做夢機制為座標,從寫入、攜帶與離線整理各自的計價單位,推演運算負載、平臺計費與檢索仲介三端的帳目變化,並推演三種情境。
在《寶可夢紅》的測試裡,兩個模型交出了相反的成績單。Claude Fable 5 全程只維護 10 個記憶檔,拿下 4 枚徽章;Sonnet 3.7 陸續寫下 413 個檔案,只換到 1 枚。約四十一倍的記憶量,換來四分之一的成果。
這組數字出自 Anthropic 在 2026 年 11 月 6 日發布的研究《The components of agent memory》。文章拆解 Claude 代理跨會話記憶的運作方式,並提出「做夢」(dreaming)機制:模型利用兩次互動之間的空檔回顧日誌、修正錯誤、提煉規則、更新知識庫,模仿人腦在睡眠中整理記憶的過程。表面上這是一篇能力報告,攤開數字後更像一份成本研究。記憶的寫入、儲存、注入與離線整理,各有計價單位,而這些單位開始決定代理產品的毛利結構。
四層記憶,四種計價單位
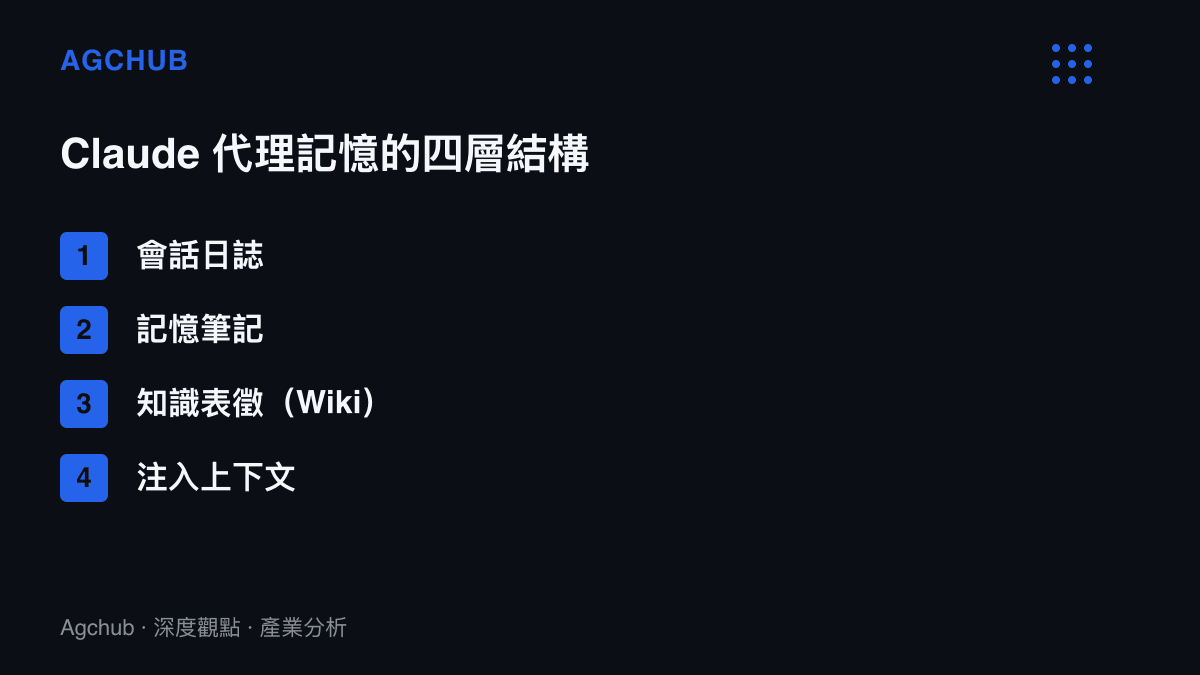
研究將代理記憶分為四層:會話日誌、記憶筆記、知識表徵(如 Wiki)、注入上下文。四層的差別,在於寫入成本與攜帶成本的分配。
會話日誌是原始記錄,寫入近乎免費,體積卻隨任務長度線性膨脹;要把整份日誌帶進下一次對話,按 token 計費的帳單會立刻反映。記憶筆記經過篩選,寫入時支付一次整理運算,攜帶時只佔少量 token。知識表徵的生成成本最高,需要多輪整理才能從日誌長出結構,但一旦成形,單次呼叫的邊際成本最低。注入上下文是最終進入模型的份量,也是每次呼叫都要重付的科目。
10 對 413 的差距就落在這條階梯上。每個記憶檔在每次會話被注入時都要重付 token,413 個檔案等於把攜帶成本乘上約四十一倍,還稀釋了真正有用的規則。Anthropic 的結論是優先儲存策略、計畫與經過測試的規則,不斷變動的螢幕狀態留在日誌層即可。換成財務語言,記憶寫入是一筆資本支出,該問的是這筆支出未來會被攤提幾次。
做夢是一道離線工序
「做夢」的位置在兩次互動之間。模型趁空檔回顧會話日誌,比對、糾錯,把零散經驗改寫成可複用的規則。研究記錄了一個糾錯案例:Claude 把寶可夢中心的位置記錯,在原地反覆折返;系統比對原始日誌修正這條記憶後,該次運行才抵達下一座城市,未修正的對照運行始終沒有完成目標。
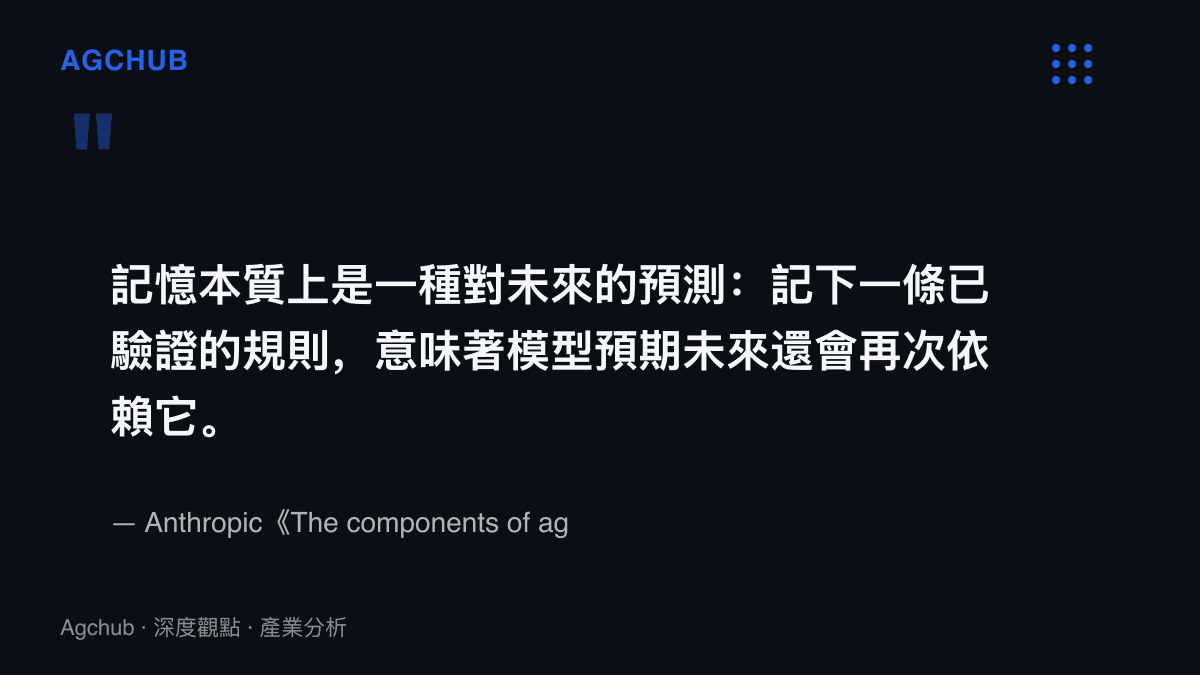
研究對記憶的定義值得單獨摘出:記憶本質上是一種對未來的預測。
報酬端有數字。在持續學習基準 CL-Bench 的資料庫問答任務上,Claude Opus 5.5 啟用記憶後平均得分 0.838,無記憶基線為 0.655,差距 18.3 個百分點;Sonnet 5.5 從 0.644 升至 0.833,差距 18.9 個百分點。研究同時觀察到,能力較強的模型能自主跑完失敗、反思、驗證、總結規則的循環。記憶機制放大了既有的模型差距,同一套架構裝在旗艦與中階模型上,拉開的幅度並不相同,這對分層計費的產品線是直接輸入。
六十四倍整理換三點七倍達標
企業場景的實驗給出最像成本曲線的一段。約 35 萬份企業文件,讓 Claude 透過多輪做夢逐步構建 Wiki:做夢從 2 次會話擴大到 128 次,25 道問題的達標率從 13% 升至 48%;再將 Wiki 與搜尋工具結合,綜合得分從 54% 升至 61%。
兩端相除,離線整理的投入放大 64 倍,達標率放大約 3.7 倍,後段還要靠搜尋工具補上 7 個百分點。離線運算買到的正確率,邊際產出明顯遞減,整理到第幾輪該停,是預算問題。

把整理排進離線時段,在運算史上並不新鮮。大型主機時代的夜間批次、資料倉儲年代的隔夜 ETL、資料庫在離峯時段重整索引,都是同一類調度:互動路徑追求低延遲,整理交給空檔產能。這一回的差別在於,被整理的是模型自己的經驗,執行整理的也是模型自己。神經科學裡睡眠期間記憶重播的觀察提供了命名靈感,商業上的重點是那條調度線:互動運算與離線運算,從此分開列帳。對算力供應商來說,這是多出來的一個可排程負載類別;在AI 監管風險被寫進估值的那次長黑之後,資本支出帳上的每一欄新增,市場都會重新計價。
受惠與承壓的兩份名單
運算端先受益。做夢讓每個代理的運算量分成兩欄:互動時的即時推理,加上空檔的離線整理。代理規模一旦上量,離線整理就是新增需求,而且特性偏向批次、可排程,適合填補 GPU 叢集的空檔,拉高整體使用率。
平臺端拿到的是留客工具。記憶筆記與 Wiki 是使用者專屬資產,累積愈久,搬到另一家供應商的重建成本愈高。計費單位因此有機會從單純的 token,轉向按代理、按記憶容量或按整理輪數的訂閱結構。
承壓的一端在仲介層。35 萬份文件的實驗顯示,代理自己長出的 Wiki 加上搜尋工具,就能把綜合得分推到 61%。檢索編排與企業知識管理軟體的加值空間被壓縮:知識庫自動構建曾是這些產品的收費項目,如今成了模型的副產品。當代理能力快速跌價,可收費的層次跟著移動,方向與DeepSeek Agent 教學頁上的零元技術棧一致:免費的部份愈來愈多,留下來收費的是整理、治理與長期儲存。
三種情境
產品化順利的情境裡,供應商把做夢包成計價功能,企業版按整理輪數與記憶容量收費;離線運算填補雲端空檔,代理續約率隨記憶累積上升,檢索仲介與知識管理工具加速被併入平臺。
成本門檻浮現的情境裡,64 倍投入換 3.7 倍達標的邊際曲線若無法改善,只有高價值工作負載負擔得起完整整理;消費級代理拿到刪減版,旗艦與中階模型的差距再被記憶品質拉開,市場分層加深。
錯誤累積的情境裡,治理成本先行。糾錯靠比對原始日誌完成,本身就是額外運算;一旦修正速度趕不上錯誤寫入,錯誤規則會隨 Wiki 攤提到後續每次任務。可稽核的記憶、寫入審核與回滾機制將成為採購要求,供應商的成本表多出一列品質保證支出。
Anthropic 自己列出的未解題目是何時寫入、如何更新、如何避免錯誤累積。做夢能否讓代理更聰明,資料已經給出答案;能否讓供應商更賺錢,取決於篩選與整理的成本曲線哪一端先被壓下來。