
只判斷、不生成:Jev 用 GPT-6 的 1/267 成本,另開一張決策帳
海外爆紅的判斷模型 Jev 標榜成本僅 GPT-6 的 1/267,本文從判斷與生成的分業、B 站數十支影片的播放量階梯,到開源 Laya 三天掀桌,拆解這波熱潮的成本結構與受惠承壓方。
9 月 18 日起,在 B 站搜尋欄輸入「Jev」的使用者會看到一頁更新極快的結果:數十支影片,最長 36 分 30 秒,最短 15 秒,發布時間從三天前一路排到一小時前。頭部兩支播放量 8.1 萬與 8 萬,尾端有影片掛著個位數。這些影片講的是同一件事:一個海外爆紅的模型,只做判斷、不生成文本,成本號稱只有 GPT-6 的 1/267,速度號稱快 200 倍。播放量會折舊,267 這個倍數背後的成本結構,比熱潮本身值得攤開。
判斷與生成的分業
B 站科普圈對 Jev 的定位相當一致。有影片標題直接寫明「為軟體自動化而生的 AI 決策模型」,有人以 System One 為題拆解它的概念層,一支 22 分 59 秒的教程以 TypeSafe Jev 為題,下了判語:它根本不是聊天 LLM。說法各異,指向同一個架構選擇:把決策環節從生成式模型裡剝離出來,單獨定價。
1/267 的源頭要先回到生成式模型的成本結構。自回歸解碼按 token 計費,回應越長,生成步驟越多,注意力計算與 KV 快取的開銷同步放大。當任務只需要回答「選 A 或選 B」「這筆資料留或刪」「下一步呼叫哪個工具」,用生成式模型處理,等於按包裹重量付掛號費去寄一張明信片。
判斷模型的輸出空間小一到兩個數量級。分類、路由、篩選、判停這類決策,答案可以收斂為單一選項或一組權重,模型沒有理由維持通用生成模型的體積與計算量。1/267 的成本比與 200 倍的速度宣稱,都沿著「輸出短、計算少」這條路得出。對 Agent 工作流而言,這層分業改寫的是決策密度:過去每一次「要不要繼續」的詢問都按生成價目表收費,流程傾向把判斷次數壓到最低;判斷環節有了獨立價目表之後,密集決策的邊際成本降到接近可忽略,流程可以拆得更細、問得更頻繁。
實測影片標出了這個模型的落點。有人拿一萬條評論實測篩選速度,有人讓 Jev 玩《植物大戰殭屍》並真的通關,有人用它驅動橫版跳躍遊戲、按玩家行為即時調整關卡,也有人把 Jev 接入微信。這些示範分兩類:工程整合類展示它在軟體自動化裡的決策價值,獵奇演示類(擰魔方、應付女朋友)負責傳播量。兩類之間的縫隙,由一支標題寫著「打假爆火的 JEV 演示:有些 demo 太扯了」的影片補上,2310 次播放,提醒觀看者示範畫面與能力邊界之間存在距離。
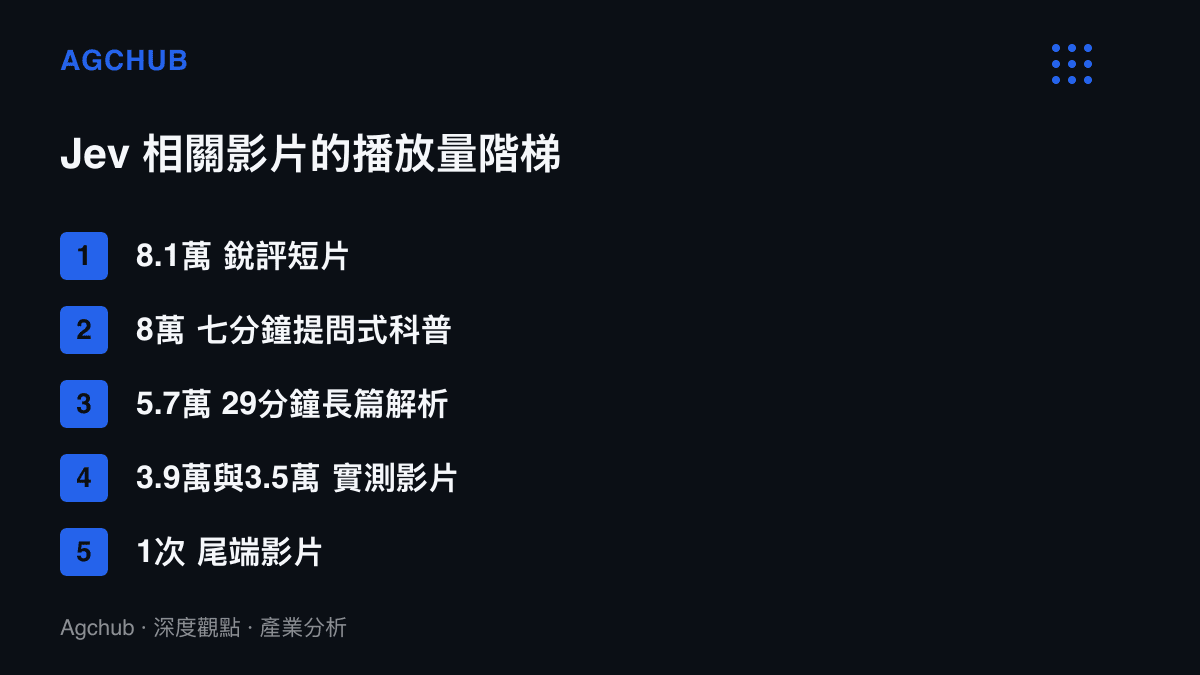
數天鋪滿一頁搜尋結果的流量階梯
頭部兩支影片都在七分鐘內。8.1 萬播放屬於 6 分 43 秒的銳評「你管這破玩意叫 Jev?」,8 萬播放屬於 7 分 27 秒的提問式科普「一個只做判斷的 AI,到底有什麼用?」。第三名換成 29 分 15 秒的長篇,標題把「價格、能力邊界與使用方法」寫進去,拿 5.7 萬播放。再往下是 3.9 萬與 3.5 萬的兩支實測,然後衰減到 7000、5000、4000 量級,一支 4102 播放的「如何訓練一個屬於自己的 Jev」停在進階教學的位置,尾端是個位數。
兩個結構特徵值得記錄。其一,流量與片長沒有正相關,吐槽框架與「到底有什麼用」框架勝過教程與長科普,說明這波觀看需求的主流仍是理解議題,還沒走到動手部署。其二,生產線的原料成本接近零:熱點本身免費,模型介面公開,剪輯模板現成,於是 15 秒的接入示範與 36 分 30 秒的原理長文共用同一個搜尋詞。頭部兩支合計逾 16 萬、尾端個位數的冪律分佈,與先前分析的B 站零元遊戲貨架的流量階梯同構:免費原料、以時計價的生產、向框架創新者集中的收益。
封神三天,開源掀桌
「Jev 才封神三天,開源 Laya 就把桌子掀了。」這支 7268 播放的影片,標題寫下這波熱潮的第二個關鍵數字:3 天。
追蹤影片隨即鋪開。「laya 就快了 7 倍」拿 4891 播放,「速度碾壓 Jev 近 20 倍」拿 5109 播放,「Jev 熱度還在,Laya 專案又來了(更快)」拿 3099 播放。7 倍與近 20 倍同時存在,測試條件沒有統一口徑,互相矛盾的宣稱數字本身成了下一批內容原料。另有一支 6728 播放的影片在標題裡留下但書:「是的,Jev 瘋了,但有個條件」。
開源替代是模型類產品的常見壓力,但替代速度因任務而異。生成模型的護城河在訓練資料、對齊細節與長尾能力,追趕者要補的帳很長;判斷模型的能力邊界窄,評測維度收斂到速度、準確率、成本三項,重現門檻低一個量級。Jev 從走紅到被開源專案正面宣戰只隔三天,這個週期本身就是判斷模型品類護城河深度的量測結果:淺到可以在一個週末內被翻越。
誰的帳單變薄,誰的被切走
受惠方先算開發者。Agent 與軟體自動化的工程團隊拿到一張新價目表,工作流裡高頻的決策呼叫改走判斷模型,單位成本降到原先的百分之零點四以下,原本因計費而克制呼叫頻率的環節可以密集鋪設。B 站知識區創作者拿到一輪流量紅利,數天內頭部兩支合計逾 16 萬播放。開源專案 Laya 借勢冷啟動,追蹤影片落在 3000 到 7000 播放區間,對一個新專案是可觀的初始曝光。
承壓方在另一端。通用 LLM API 的帳單裡,分類、篩選、路由這類低階判斷呼叫是遷移成本最低的一層,專用判斷模型把這層切走後,通用模型被迫退守真正需要長文本的環節,混合計費的空間被壓縮。Jev 自身同樣在承壓名單上:三天的開源替代週期,意味著 1/267 的成本優勢難以沉澱為長期定價權。能力邊界公開、評測口徑統一的品類,價格終將向開源基準收斂,商業價值得往低延遲託管與工程整合服務搬。
分層價目表的邏輯並不新鮮。先前拆解AI 對話與人類諮詢的三張價目表時,同一種「懂自己」的需求已經按交付形式切出三個價格帶。Jev 做的是同一件事的工程版本:把 Agent 工作流按任務性質切層,判斷一層、生成一層,各自計費。
收束:分業會留下,名字未必
兩種情境可以推演。其一,Jev 類判斷模型成為 Agent 架構的標配中間層,生成模型退守長文本環節,兩層價目表固定為產業預設值。其二,開源在數週內抹平差距,判斷能力淪為基礎設施的免費附屬,這波熱潮只沉澱出一條架構經驗。
兩種情境有共同點:被寫進成本結構的是分業本身,判斷與生成拆開計費,決策密度不再受生成成本約束。至於 Jev 這個名字,B 站的播放量已經給出順序,第一批教學影片的熱度正被 Laya 的追蹤影片分走,一週內走完一輪內容生命週期。注意力折舊的速度,跑在模型疊代前面。