
90.5%降到81.0%:Kimi K3.1 Pro開源之前,月之暗面先刪掉9.5個百分點
月之暗面在Kimi K3.1 Pro開放權重前,於中期訓練與強化學習兩階段削減網路攻防能力,本文以9.5個百分點的基準落差為座標,對照Llama、DeepSeek以來的權重開放史與閉源安全框架,拆解能力封頂對開源生態與競爭格局的傳導。
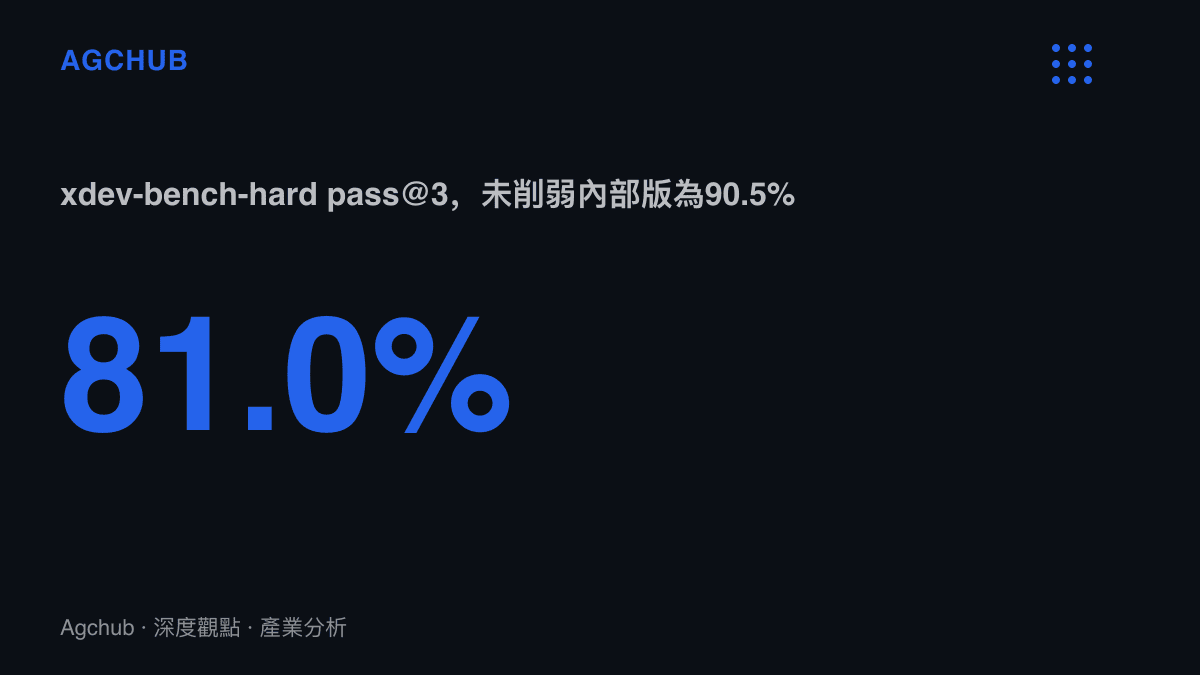
90.5%對上81.0%。兩個數字出自月之暗面的官方技術部落格,量測對象是漏洞發現與利用基準xdev-bench-hard,指標為pass@3,即三次嘗試內的成功率。9.5個百分點的差距來自發布流程裡一道刻意安排的工序,與訓練過程中的自然損耗無關。月之暗面近日發布Kimi K3.1 Pro,計畫在11月4日前開放模型權重;為了降低開源版本的網路攻防能力,研發團隊在中期訓練階段過濾網安攻防相關資料,並在強化學習階段移除網安任務,僅保留通用編程任務。
廠商主動公布自家產品被削減的幅度,在開源模型的歷史上少見。多數技術報告只列最終分數,很少同時揭露「如果不刪會是多少」。這組對照數字,等於把一次策略轉向的成本直接寫成報表。
先刪資料,再放權重
兩道槓桿都在訓練端。中期訓練的資料過濾,決定模型看過什麼;強化學習的任務移除,決定模型練過什麼。這種處理與部署端的防護措施(系統提示、輸出分類器、速率限制)性質不同:API上的閘門可以隨時調整,權重一旦開放下載就無法回收,開放權重的模型沒有遠端開關。要在釋出之後保留任何控制,只能把控制焊進參數裡。
資料層的刪除還帶來持久性。使用者在公開語料上微調,難以補回被過濾掉的知識;整條產品線裡最稀缺的資產,正是被刪掉的那批攻防資料。從通用編程任務被完整保留的安排看,削減按垂直領域切割:開源版在多數能力上仍是該廠最強的可得版本,唯獨資安攻防這一格被設了上限。月之暗面同時把「不開放權重發布處於全球網安攻防能力前沿的模型」列為開源原則,等於預告這道上限將長期存在。

開放權重的舊命題:把最強的送出去
回看2023年以來的權重開放史,各家共享同一個前提:開放的就是最強的。Meta在2023年7月以Llama 2開放權重,2024年7月的Llama 3.1 405B被官方定位為首個前沿級的開放模型。2025年1月,DeepSeek以MIT授權釋出R1,輝達單日下跌約17%、市值蒸發近6,000億美元,市場第一次為零價格的前沿推理能力重新定價。同年7月,月之暗面自己以K2加入權重開放的行列;到2025年年中,Qwen家族在Hugging Face上的衍生模型突破十萬個,超越Llama成為規模最大的開源模型家族。
這套打法的商業邏輯並不複雜:權重是最便宜的獲客與生態工具,模型層被商品化之後,收入記在API與企業服務上。K3.1 Pro把前提拆成兩半:開源的仍是該廠最強的通用編程模型,資安攻防這一格被劃出贈送的範圍。同一段時間,中國模型廠商的產品線調整轉趨頻繁,兩代併一代的資源收攏是另一種收縮戰線的方式;差別在於MiniMax收的是品項數量,月之暗面收的是能力欄位。
控制點的位置:與閉源安全框架對照
閉源陣營早有一套能力管控的語彙。Anthropic的責任擴展政策(RSP)按ASL能力等級設下部署門檻;OpenAI的Preparedness Framework對網路攻擊、生化武器等危險能力做發布前評估;美英的AI安全研究機構也先後與主要實驗室建立部署前測試安排。這些機制的共同點是模型留在屋內:使用者拿到的是經過多層閘門的輸出,權重本身從不離開廠房。
月之暗面把控制點往前搬了一步:權重照常釋出,特定能力的上限卻在釋出前就被壓低。若問題是「外界能否取得前沿網安能力」,兩條路徑的結果趨同;差異在於開源版的使用者仍握有權重級的掌控權,從本地部署到微調蒸餾都在自己手裡,這是閉源API永不提供的介面。一個介於開源與閉源之間的第三種品類於是成形:能力封頂的開放權重。
帳面上還有另一半。被劃走的能力並未消失,它留在廠商可控的版本裡;未來無論以API或企業資安專案的形式輸出,都是可計費的項目。封頂同時服務兩個目的,風險管理對監管交代,產品分層對損益表交代。
監管的背景板
時點並非偶然。歐盟AI法案對通用模型提供者的義務已在2025年8月生效;中國主管部門則推動23項AI技術列入出口管制的新規,DeepSeek與MiniMax在政策發布六天後完成登記的前例顯示,模型與技術輸出的交會點已經寫進政策文本。對一家計畫全球開放權重的中國廠商而言,主動證明開源版本不在「全球網安攻防能力前沿」,等於提前把自己移出最敏感的監管區位。月之暗面的原則陳述用的是安全框架的語言,削減幅度用的是基準測試的語言,兩者疊加,構成一份對監管端預先備好的說明文件。
誰受惠,誰承壓
受惠端先看廠商自身。能力差額留在可控版本裡,成為未來的營收科目,開源版則繼續扮演獲客與生態的工具。合規敏感的企業採用者是第二層受益者:拿到權重的同時附帶廠商量化的安全邊界,導入審查的成本下降。監管端也省事,風險敞口收縮,且證據由廠商自行提供。
承壓端同樣具體。資安研究與紅隊社羣過去以開放權重補足工具鏈,合法的滲透測試與漏洞研究現在少掉最高的那一格。以開源權重為基座的衍生模型生態會繼承同一個天花板,微調與蒸餾都繞不過去。更結構性的影響落在基準的可信度:公開榜分數與內部上限脫鉤之後,同一張榜單量到的可能是各家的切割策略,「開源追上閉源」的敘述從此需要加註條款。若封頂成為慣例,閉源API在垂直能力上重新取得定價空間,開源版的競爭軸心將移往成本與主權部署。

三種情境
情境一,慣例化。其他權重開放廠商跟進,資安先被劃走,其後延伸到生化與模型自主性等安全框架既有的欄位。開源的定義從「釋出最強模型」移向「釋出通過安全篩選的模型」,廠商之間比較的是切割的精細度與揭露的完整度。
情境二,反向分化。有廠商評估合規風險後,選擇釋出未削減的權重換取開發者心智,開源陣營分岔成兩條軌道,合規成本變成競爭變數,開發者以流量與衍生模型數量投票。
情境三,監管固化。能力上限從廠商自律升級為規則文本,寫進出口管制編碼或通用模型義務清單,封頂從差異化策略降格為進場門票。
9.5個百分點的價值,在於它被公布了。市場第一次拿到一份可比對的開源折價數據:代價多少、砍在哪裡、由誰決定,全寫在技術部落格裡。後續值得追蹤的變數有二:其他廠商是否跟進揭露內部版與釋出版本的差距,以及下遊採用者會不會把「未經削弱」寫進採購需求。開源與閉源的競爭不會結束,只是比較的欄位多了一項:哪些能力被留下,哪些能力被送出了門。