
130GB/s、64GB與一顆NPU:羣聯讓固態硬碟自己跑模型
羣聯在SC26展出內建NPU與64GB記憶體的企業級固態硬碟,以及pSLC混合QLC的介質方案,本文以資料搬移與快取分層兩筆帳為座標,對照運算儲存第一波退潮的教訓,拆解控制器廠往企業端移動的傳導結構與三種情境。
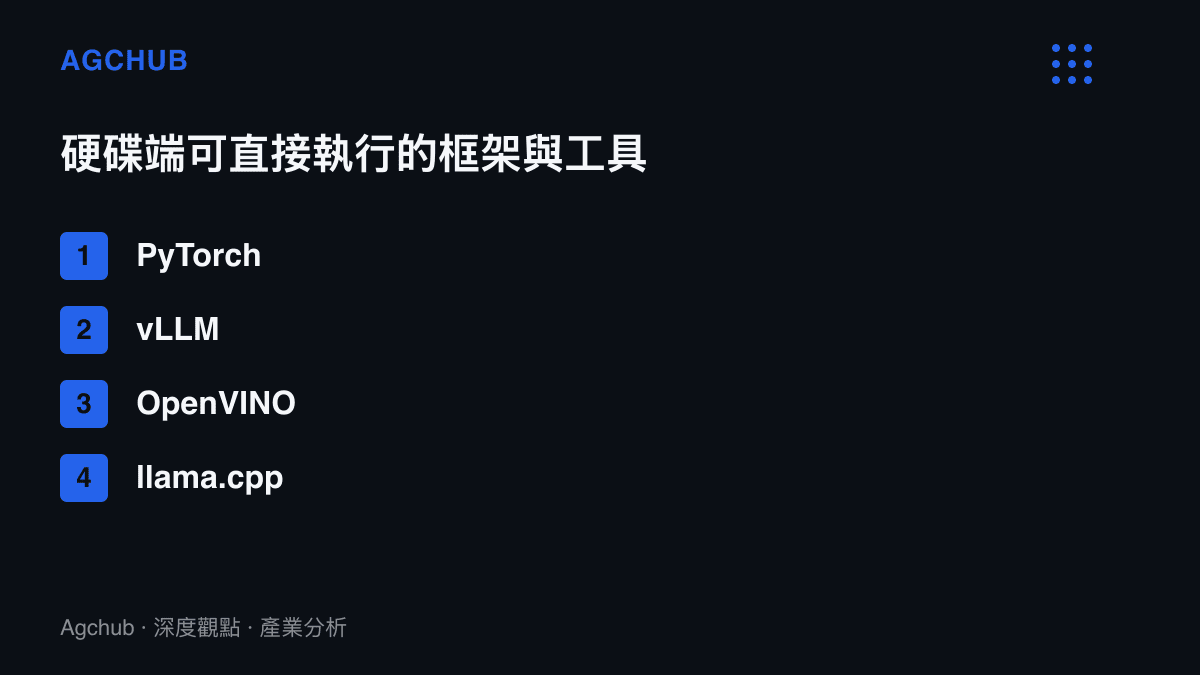
130GB/s的頻寬、64GB的記憶體、一顆神經網路運算單元。這組數字過去只會出現在伺服器的規格表,這次卻掛在固態硬碟名下。據Tom’s Hardware於11月21日報導,羣聯在SC26超級運算大會展出兩款針對AI場景設計的企業級固態硬碟,其中一款內建NPU與64GB記憶體,可在硬碟上直接執行PyTorch、vLLM、OpenVINO與llama.cpp,主機端收到的是運算結果,整份資料集不必再走一趟匯流排。
兩款產品,兩本不同的帳
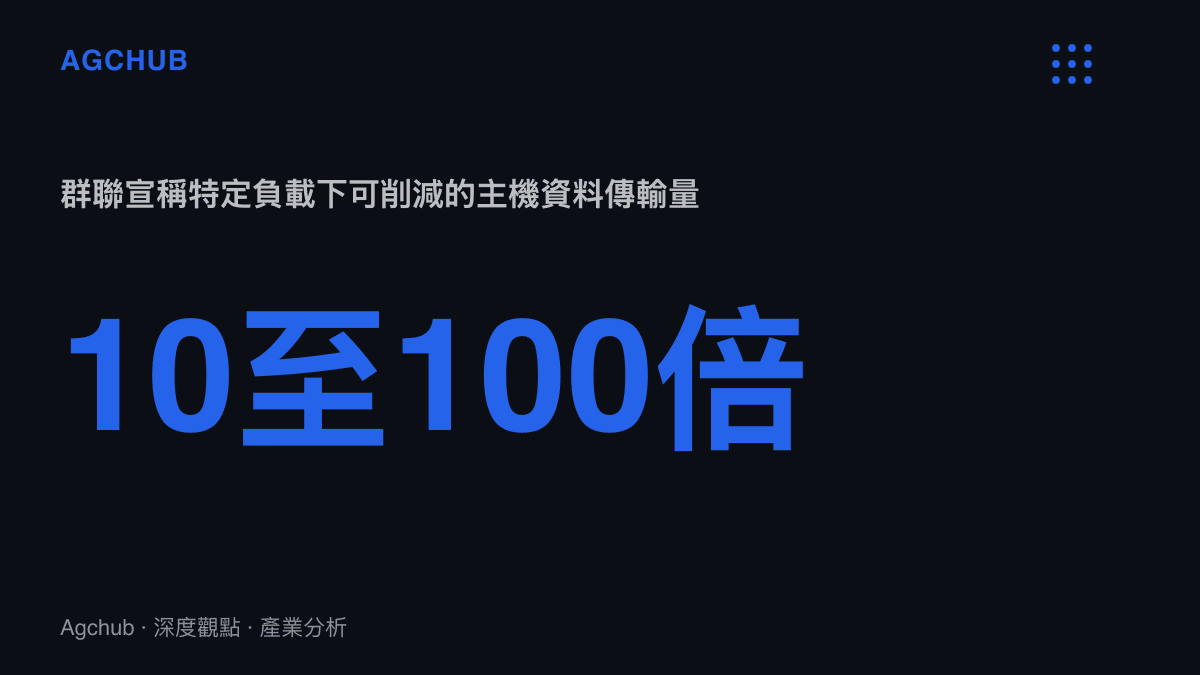
第一款把運算搬進儲存。設計思路是讓硬碟就地處理存放的資料,只回傳體積小得多的結果,羣聯表示在特定工作負載下,可減少10至100倍的資料傳輸量,主機CPU的負載隨之下降。原報導未說明130GB/s屬於單碟或叢集量測口徑;作為參照,現行消費級PCIe 5.0機種的順序讀取多在14至15GB/s之間,兩者相差接近一個數量級,這個數字本身有待廠商進一步定義。
第二款不碰運算,改碰介質。名為Mixed Media的設計把高耐久的pSLC快取區與大容量QLC整合在同一顆硬碟,交由一顆16通道主控管理:部分QLC被切換為SLC工作模式,用容量換取寫入效能與壽命;兩個儲存區各掛獨立命名空間,主機依資料型別選擇放置位置,不必安裝額外軟體。羣聯的定位很清楚,這套組合要取代的是系統內的獨立快取碟。
資料搬移是那道最貴的工序
AI推論的成本結構裡,資料移動長期是被低估的欄位。向量檢索、嵌入與前處理程序,反覆把同一批資料從硬碟搬進主機記憶體再送進加速卡,每一GB都要支付匯流排頻寬、DRAM容量與CPU週期的費用;在多數環節,搬運資料的能耗高於對它做運算。把NPU放進硬碟,等於把結算點移到資料落地之處。
64GB記憶體搭配llama.cpp,指向量化模型的推論路線。以常用的4位元量化推算,這個容量足以容納數百億參數等級的模型本體與推論時的KV快取,產品定位落在中小模型與檢索增強生成的前段工序,與前沿大模型的訓練無關。計價的顆粒也在同步變細:當Gemini 4 Neon把推論成本切成四檔賣,API市場已經把成本拆到快取命中與否,儲存端的就地運算是把這本帳再往下延伸一欄。
這個概念不是第一次出現
運算儲存在2018至2021年間有過第一波。三星SmartSSD把FPGA與快閃記憶體裝進同一個機殼,NGD Systems、ScaleFlux與Eideticom先後推出可程式化硬碟,SNIA也同步推進標準化。這一波最終沒有形成氣候:各家軟體棧互不相通,移植程式的成本壓過就地運算省下的錢,主機端通用運算的單位價格又持續下探,採購理由始終湊不齊。
現在的觸發條件換了。AI資料湖的規模以EB計,檢索增強生成的管線每天重複搬運同一批向量與文件,資料移動的帳單第一次大到值得為它設計硬體。羣聯自己也鋪過一段前置路徑:先前的aiDAPTIV+方案把固態硬碟當作主機記憶體的延伸,用在工作站端的小模型訓練;這次展示把運算單元本身搬進硬碟,方向連續,差別在運算不再佔用主機資源。
控制器廠往企業端擠
企業級固態硬碟的主控晶片,長期由三星、SK海力士、鎧俠與美光自研自用,第三方主控廠的主場在消費與零售端。AI儲存需求推開了這道界線:資料中心對高容量企業級SSD的採購,放大了對主控與整套解決方案的需求。羣聯2026財年前三季營收年增290%,歸屬母公司淨利719.38億新臺幣,營收創歷史同期新高,這張損益表給了它把概念品推上SC26舞臺的本錢。
SC26的觀眾結構說明展示目的。超級運算年會的入場者是國家實驗室、超大規模資料中心與系統整合商,正是企業級儲存認證鏈的最上遊,一場展示對應的是之後一到兩年的導入評估。另一面的約束同樣具體:NPU與64GB記憶體都加在物料清單上,而記憶體正處於漲價週期,這與三星旗艦在雙軌採購下面對的記憶體漲價壓力同源。硬碟加料與手機物料膨脹讀的是同一張DRAM與NAND報價表,差別在企業級客戶對單位成本有高得多的容忍上限。
快取那一本帳,兌現更快
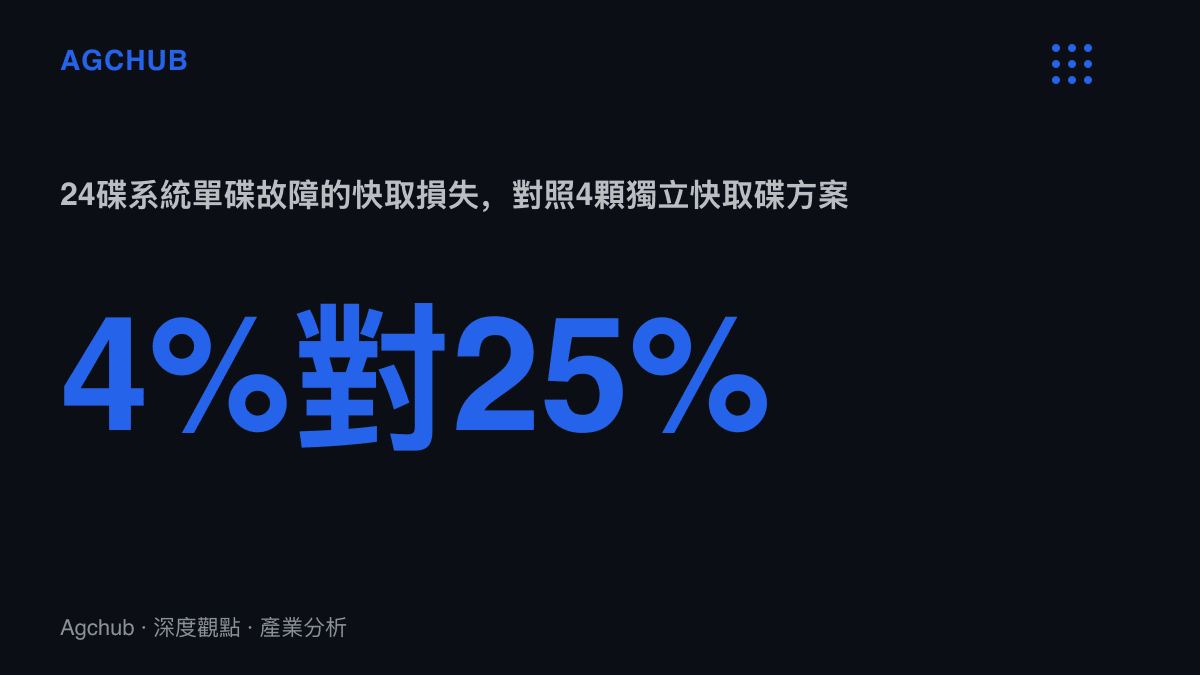
相較NPU概念款,Mixed Media的商業門檻低一個量級。它處理的問題很具體:寫入密集的快取層與讀取密集的容量層,過去要靠不同硬碟分層,獨立快取碟一旦故障,快取池立刻出現破口。羣聯的算術是,在24顆硬碟的系統裡壞掉一顆,快取損失為4%;同樣的快取容量交給4顆獨立硬碟承接,壞一顆就是25%。英特爾Optane退出市場後,寫入密集快取層本來就少了一個現成選項,這套把快取攤到整個硬碟羣的設計,填的正是那個位置。
犧牲的欄位是容量。SLC模式每個儲存單元只放一個位元,對照QLC的四個,同樣的晶片可用容量縮至約四分之一,換回數倍於QLC的寫入壽命與速度。這筆交換能否成立,取決於負載分布:以讀取為主的AI資料湖,帳面劃算的機率高。同類設計已開始外溢,奧睿科日前發表的FlashMem FM9800同樣劃出pSLC快取區,概念的應用範圍正從企業端往高階個人端移動。
傳導順序與承壓位置
路線若成立,第一圈受惠者是NAND原廠與第三方主控廠。硬碟的單位售價與附加價值同步上移,主控廠首次有機會以運算能力作為差異化條件,擠進原廠自研主控盤據的企業級席位;對羣聯而言,這是一條從零組件供應商轉向方案供應商的階梯。
承壓端分兩層。短期最直接的是獨立快取層與分層軟體的供應商,Mixed Media把分層做進硬碟韌體,等於抽走一層中介軟體的存在理由。長期看,若就地運算普及,主機CPU、DRAM與東西向網路流量的需求成長會被削去一截,影響落在伺服器處理器與網通設備的長線位元需求上。網路側的DPU也在爭同一筆卸載預算,兩條路線終會在資料中心的持有成本表上對撞。
三種情境
情境一,標準化重演第一波的困境。各廠軟體棧互不相通,超大規模客戶不願被單一供應商綁定,產品停留在展示與試點,NPU硬碟成為年會上的常備演示品。
情境二,特定負載先行。向量檢索、日誌掃描與檔案過濾這類搬運量大、運算輕的工序率先商用,內建NPU的硬碟以檢索層身分進入資料湖,與GPU伺服器形成分工,結算單位換成每次查詢的成本。
情境三,成本環境反轉。NAND價格若回落,或PCIe 6.0與CXL把傳輸瓶頸放寬,就地運算省下的帳同步縮水,產品退回一般企業級SSD的價格競爭。
兩款產品對應兩個時間尺度。Mixed Media在本輪採購週期就有機會轉成訂單,NPU硬碟則要穿過認證與軟體生態,以年為單位計息。羣聯把兩者並排展示,等於同時押注儲存端漲價的兩種理由:一種靠介質組合,一種靠運算遷移。哪一筆先兌現,取決於資料中心接下來更缺的是容量、頻寬,還是搬資料的電費。