
從按次計費到只付電費:一套開源 OCR 工具箱重排文件辨識的成本表
以 RapidOCR 的 Apache 2.0 授權與純 CPU 推理為座標,拆解文件辨識從雲端按次計費轉向本地近零邊際成本的帳目結構,並推演私有化授權商、雲端 API 與服務化新進者的承壓順序。
多模態大模型上線這幾年,文字相關的任務幾乎全被重新標價。文件辨識這門超過三十年的老生意卻出現反向移動:辨識模型正從雲端帳單裡,搬回企業自己的機房。10 月 19 日,開發者社羣掘金的一篇工具評測把 RapidOCR 再次推進檢索熱區,這套由 RapidAI 團隊維護的開源工具箱,賣點濃縮成三個條件:免費商用、離線執行、純 CPU 就能跑。
工具評測本身談的是安裝與調用,背後其實是一道產業題:當辨識模型的品質差距被開源方案抹平,按次收費的雲端服務還剩下多少計費基數。
一張發票的兩本帳
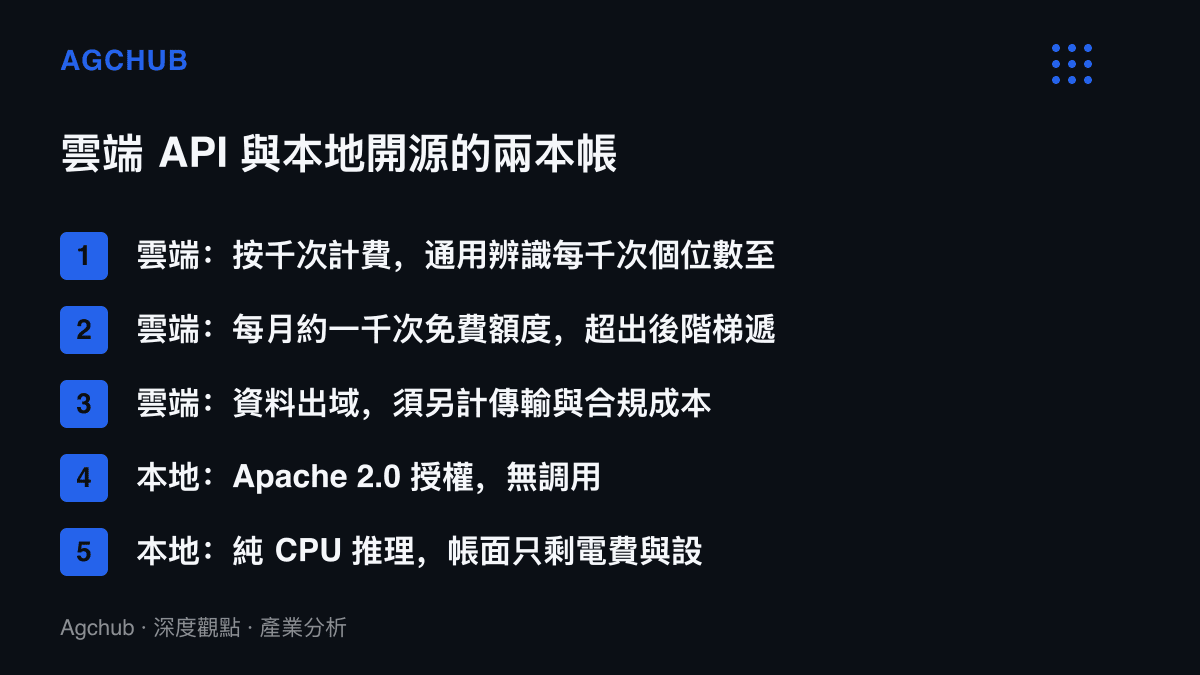
同一張待辨識的發票,走雲端 API 與走本地模型,記帳科目完全不同。雲端路徑下,主流雲廠的公開價目表以千次為計價單位,通用文字辨識常見於每千次個位數至數十元人民幣,手寫、表格與證件類場景再加價;多數廠商另提供每月一千次上下的免費額度,超出後按量階梯遞減。本地路徑下,Apache 2.0 授權把模型權重與原始碼的費用歸零,推理交給 onnxruntime,x86 伺服器甚至一般辦公電腦的 CPU 即可執行,帳面上剩下的只有電費、既有設備攤提,以及一次性的工程整合工時。
兩條成本曲線的交叉位置可以粗算。以每千次人民幣 10 元的中位假設估算,每月一百萬次調用的業務,年帳單約 12 萬元;換到本地,一次性投入落在工程師數日到數週的整合與測試工時,之後每次調用的邊際成本趨近於零。調用量越大,兩條曲線的張口越寬,中大型用量與隱私敏感客戶,構成轉向離線方案的主力。
這種計價分歧在其他市場也反覆出現過。手機攝影領域,徠卡聯名認證費對上免費演算法移植包的兩套邏輯長期並存,品牌溢價與零成本流通坐在同一層貨架。消費端軟體的買斷與訂閱計價之爭則顯示,收費模式一旦被免費或一次性方案對位,訂閱曲線就很難守住原來的斜率。
免費額度是緩衝,也是前提
雲端 OCR 的價目表內建一道緩衝:免費額度把長尾開發者留在雲上,等用量長大,計費自然啟動。這套結構成立的前提,是自建部署的門檻夠高、夠貴。
開源陣營過去的短板在品質。上世紀八〇年代誕生於惠普實驗室、2006 年由 Google 接手開源的 Tesseract,長年是開源 OCR 的預設選項,處理印刷體英文尚可,遇到複雜中文版式便明顯喫力,這次評測作者以 tess4j 整合的挫折經驗即是典型。轉折發生在 2020 年,百度開源 PaddleOCR,模型品質追平商用 API,開源方案的品質天花板被一次性抬高。
代價留在工程側。PaddleOCR 原生綁定 PaddlePaddle 框架,部署時得把整套框架依賴一起搬進機房,Python 之外的技術棧整合成本可觀。RapidAI 動的手術相當精準:將模型權重轉換為 ONNX 中間格式,剝離框架依賴,推理交給 onnxruntime、ncnn 等輕量引擎,對外提供 Python、C++、Java、C# 四種接口,官方並維護 7 種引擎的 Docker 鏡像,覆蓋桌面、行動裝置與容器環境。模型權重與推理框架解耦之後,部署摩擦的最後一段被拆除,檢測、方向分類、辨識的三段式管線可以在任何一臺 CPU 機器上啟動。
雙軌玩家與被壓縮的中間地帶
值得注意的是,被壓縮的收費空間,有一部分屬於模型的開源者自己。百度同時經營兩軌:PaddleOCR 開源餵養生態與人才池,智慧雲的 OCR API 承接收費需求。RapidOCR 類工具接走的,正是雙軌之間「想用開源模型、又不想扛框架部署」的中間地帶。收費側的適用範圍因此往兩端收縮:一端是免費額度內的低量用戶,另一端是需要高精度模型、SLA 保證與複雜版式理解的高階客戶。
多模態大模型在後一端的優勢確實存在,表格結構還原與跨欄語義理解的辨識上限更高,代價是按 token 計費與 GPU 推理,單頁成本高出輕量管線數個數量級。企業知識庫與檢索增強生成帶動的文件數位化需求總量仍在放大,其中絕大多數頁面只需要把印刷文字轉成結構化欄位,這正是輕量管線的成本優勢區。生成式浪潮抬高的是文件理解的天花板,中低複雜度的辨識工作反而更依賴低成本方案。

傳導:帳單變薄的順序
受惠端的排序相當清晰。ISV 與中小軟體商排在首位,Apache 2.0 允許把模型直接打包進閉源商用產品,嵌入辨識功能的邊際成本歸零,報價彈性同步放大。政企與金融機構其次,發票、身分證、合同不出域,資安審查、傳輸加密與資料外洩風險一併省下。邊緣與行動裝置場景受惠於 ncnn 引擎對移動端的優化,離線執行省下流量與延遲;出海應用則因資料不上雲,直接減輕部分市場的資料本地化壓力。
承壓端的順序相反。首當其衝的是以私有化部署授權為主業的商業 OCR 廠商,過去向政企收取人民幣數十萬元級的授權費,如今開源方案加上整合服務即可覆蓋多數需求,報價單裡的授權欄位被壓薄,收入被迫往客製開發與維運服務遷移。其次是雲端 OCR API 的計費基數,中段客戶流失同時反映在量與價兩端。第三層是以 API 轉售為業的整合商,價差空間被壓縮後,商業模式只剩帳務與客服外包的價值。
三種情境
情境一,雲端轉向增值層。通用辨識單價持續下探,最終成為引流的免費品項,計費重心移往表格結構還原、多模態文件理解與流程自動化,API 廠商改以工作流程計價,以辨識次數計費的時代結束。
情境二,開源服務化。圍繞 RapidOCR 長出客製訓練、模型微調與附帶回應時間保證的付費維運服務,工具箱成為服務商的前端,成本競爭移到服務層,開源與收費的界線從產品本身移往服務契約。
情境三,推理成本曲線反轉。若模型量化與推理硬體的進展,把多模態模型的單頁成本壓低一個數量級,輕量管線的成本優勢將逐步收窄,文件辨識作為獨立品類併入文件理解與知識管理的大類,計價單位從頁、從次變成 token。
三種情境共享同一個起點:辨識模型本身已經不再稀缺,Apache 2.0 的授權條款把最後一道收費理由拆掉了。文件辨識市場接下來的競爭,多數會發生在部署完成之後的服務契約裡,而非模型本身。