
722份手稿與3小時推理:數學證明的計價單位,從人年換成算力
OpenAI單批釋出722份數學手稿、菲爾茲獎得主陶哲軒公開批評,本文以單一成果約3小時推理時間的換算為座標,拆解證明生產成本、同儕審查產能與千禧年獎金機制之間的連動與承壓方。
2002年11月,佩雷爾曼(Grigori Perelman)把第一份預印本放上arXiv,其後八個月再補兩份,三份文件構成龐加萊猜想的完整證明輪廓。數學界消化這三份文件又花了將近八年,克雷數學研究所到2010年才正式結案,佩雷爾曼本人拒領一百萬美元獎金。2026年10月上旬,OpenAI把同一段流程壓進一天:單一批次釋出722份數學手稿,「OpenAI狂發論文,數學家炮轟」的貼吧話題累積27.1萬則即時討論。菲爾茲獎得主、加州大學洛杉磯分校教授陶哲軒在10月7日的個人網誌轉載一份措辭嚴厲的聲明,並留下被廣泛轉引的一句評語,中文討論區隨後把它濃縮成「算力霸權」四個字。
陶哲軒並非AI懷疑論者。他長年推動Lean形式化與AI輔助研究,這次的不滿有具體對象:據討論串整理,該批手稿宣稱涵蓋準黎曼猜想、霍奇猜想、掛谷問題等372個結果,多數附帶Lean形式化版本可供機器驗證,但全部未經期刊同儕審查;檢視過內容的數學家對證明品質普遍保留,陶哲軒本人即對結果表示失望。爭議的核心,落在產出速率與驗證速率之間的數量級落差。
一天722份,檢驗以年計
回看世紀級成果的歷史座標,落差更清楚。1993年懷爾斯(Andrew Wiles)宣布費馬最後定理的證明,全文一百多頁,全球能審的圈子以研討班方式逐行檢驗,中途抓出關鍵漏洞,修補完成已是1994年秋天。一個定理,背後是一個人多年的祕密工作,加上一個小圈子以年計的審查。佩雷爾曼的三份預印本走的是同一節奏,只是把檢驗期拉得更長。
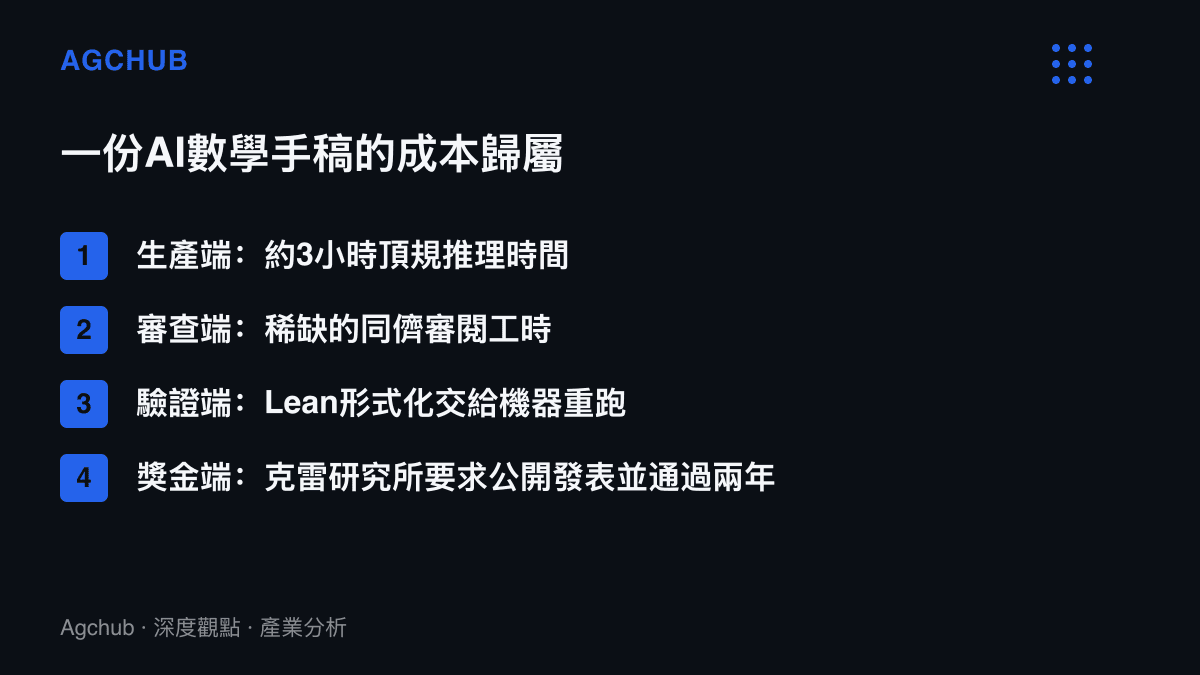
OpenAI的批次把生產端壓縮到一天,檢驗端無法同步壓縮。假設722份手稿最終只有一成經得起檢驗,72個接近世紀難題等級的結果,仍可能超過全球數學社羣一整年的頂級審查產能。審查這道工序的成本結構沒有改變:它依賴少數專家的稀缺工時,無法靠資本支出快速擴產。
計價單位換手:從人年到3小時推理
貼吧流傳的一份換算,把爭議拉回成本語言:一個成功結果平均消耗的計算量,約相當於3小時ChatGPT Pro等級的thinking推理。ChatGPT Pro的訂閱價是每月200美元,OpenAI把成果成本換算成使用者熟悉的訂閱單位,這個表述本身就是定價語言:一項數學成果的邊際成本,落在幾小時的推理時間上。
對照人年計價的舊世界,差距是數量級的。一個博士養成五年起跳,一個重要定理背後常是十年級別的訓練與研究投入。當邊際成本從人年跌到小時,產出量的約束條件跟著換手:決定產量的因素從天賦與訓練時間,移往推理算力的資本規模。陶哲軒說的「權力」,翻譯成成本結構的語言就是資本門檻,持有算力的一方決定產出節奏,個別數學家無法用人年對抗批次。
雲端推理成本逐項記帳,已是AI產品定價的顯學,小米的AI消除功能就攤過一筆1.7億臺裝置的年推理帳單。數學手稿的案例只是把同一套記帳邏輯推到極端:單位成本夠低、批量夠大,產出行為本身就成為展示。
Lean形式化則改寫驗證端的成本。2020年底舒爾茨(Peter Scholze)發起液體張量實驗,動員全球形式化志工,耗時約半年才通過核心部分的機器驗證;形式化至今仍是高技能人力工作,但它讓驗證從少數專家的口頭審查,變成可複製、可重跑的計算程序。722份手稿中附帶Lean版本的部分,驗證成本由機器吸收;未覆蓋的部分,排隊等稀缺的人類專家。
聲譽市場的定價機制被批量沖刷
克雷研究所2000年設立七個千禧年難題,每題懸賞一百萬美元,二十六年來只有龐加萊猜想結案。獎金是稀缺性定價:它預設世紀難題的生產節奏以十年計,獎金才買得到注意力與誘因。當一個實驗室能在單一批次列出觸及黎曼猜想與霍奇猜想的數百個結果,稀缺性假設失效,獎金機制的定價基礎跟著鬆動。
學術勞動市場同樣按稀缺計價。終身教職、獎項與引用指標,都建立在重要結果供給有限的前提上。批量產出若成為常態,一般性證明的邊際聲譽價值下滑,價值分化隨之出現:問題選擇與理論框架的價值上升,純執行面的證明技巧折舊加速。
圍棋市場提供了一個可對照的週期。2016年3月AlphaGo以4比1擊敗李世乭,職業棋士並未消失,但開局理論一夜折舊,訓練與賽後解說全面改用AI工具,教學與轉播生態重組。貼吧討論裡「優先使用AI的數學家佔優」的預期,走的是同一條路徑:工具普及之後,比較優勢移向最會用工具的人,而非最快的人腦。
最硬的榜單,與資本築成的門檻
對模型廠商而言,數學是推理能力最難造假的公開榜單。2024年7月國際數學奧林匹亞,DeepMind的AlphaProof與AlphaGeometry2解出六題中的四題,達銀牌積分水準。當通用基準的分數趨同,硬榜單的行銷價值反而放大:頂尖模型在LiveBench的分差一年內由15%收斂至3%,可宣傳的差距移往API牌價與資本支出回收期,數學成果批次於是成為差異化敘事的載體。
這批手稿對OpenAI帳本的意義,行銷價值優先於數學價值。722份文件的直接讀者有限,但它支撐的是每月200美元的頂級訂閱與企業級推理服務的能力敘事。展示成本低、傳播速度快,是典型的資本密集行銷。
誰受惠,誰吸收審查工時
受惠方相當明確。Lean與mathlib工具鏈的需求上升,形式化人才從冷門變搶手;雲端與GPU供應商拿到可持續講述的算力故事;善用AI工具的研究者取得單人難以企及的探索半徑。OpenAI則把最強推理能力的證明,寫進消費端與企業端兩側的定價基礎。
承壓方同樣清楚。期刊審查產能是最直接的瓶頸,而吸收這些工時的,正是被產出速率拋在後面的人類社羣。獎金機構面臨規則重寫的壓力,以論文件數為基礎的聘任與評鑑制度,則要處理件數通膨後的指標失真。中遊的技巧型研究者,比較優勢縮得最快。
兩種情境與一個轉軸
後續發展取決於驗證產能。樂觀情境下,形式化覆蓋率持續上升,驗證成本跟著推理成本一路下降,數學進入機器生產、人類選題與驗證的分工,難題清倉加速,聲譽移向定義問題的人與維護驗證體系的人。保守情境下,審查產能跟不上,未檢驗的手稿成堆積壓,聲譽市場分裂為機器可驗證與存疑兩軌,頂尖期刊退守問題重要性的審查,批量手稿淪為查詢用的資料庫。
無論落在哪一側,稀缺資源的位置已經移動:從證明能力,移往驗證產能與選題品味。計價單位換了,驗證的帳單還在排隊等人認列。